一句话定位:🕷️ The BEST Web Scraping framework that handles everything from a single request to a full-scale crawl! Don’t be shy, join here: https://discord.gg/EMgGbDceNQ and follow here for daily tips and tricks: https://x.com/Scrapling_dev。这是 GitHub 上同类项目里热度前列的一个(101.8k Star),本文按本站项目库口径做拆解:它解决什么问题、怎么装、优缺点与适合人群。口碑口径:本站未逐一亲测本文全部项目,数据来自 GitHub 公开页面(采集于 2026 年 11 月),结论以「数据事实 + 通用理性分析」为准。
它解决什么问题
自动化框架赛道这两年爆发,Scrapling 的切入点是:🕷️ The BEST Web Scraping framework that handles everything from a single request to a full-scale crawl! Don’t be shy, join here: https://discord.gg/EMgGbDceNQ and follow here for daily tips and tricks: https://x.com/Scrapling_dev。标签:ai、ai-scraping、automation、crawler、crawling、crawling-python。主要语言:Python,许可证:BSD-3-Clause,最近更新:2026-11-11——更新活跃度是判断这类项目能不能跟的第一指标,它在这一点上达标。
功能结构(据项目文档目录)
- What you can do with Scrapling
- Key Features
- Spiders – A Full Crawling Framework
- Advanced Websites Fetching with Session Support
- Parsing and Data Extraction
- AI Features
热度与生态数据
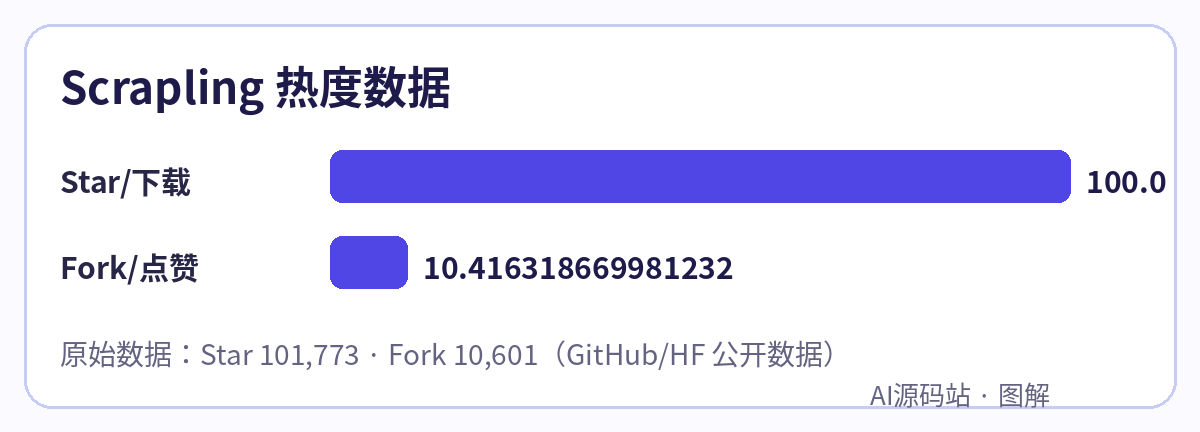
- Star:101,773;Fork:10,601(Fork 数高说明二次开发的人多,生态通常更耐用)
- 仓库:github.com/D4Vinci/Scrapling
- 本站镜像:点击下载本站镜像(Scrapling 源码包 · 4.3 MB)(国内直连,不用翻墙拉 GitHub) · GitHub 原仓库
- 本站拉取(Git 克隆):
git clone https://dl.yuanmazhan.net/git/scrapling.git——国内直连 GitHub 拉不动时用这个地址,代码与原仓库一致;本站镜像为定期同步快照,要追最新版用上方 GitHub 原仓库
安装上手
按项目官方 README 的方式起步(原文命令):
Advanced stealth mode
装完先把示例跑通,再动配置——这类项目九成的坑出在环境变量与模型 Key 没填对。
优点与缺点(通用理性分析)
- 优点:开源可控、社区规模摆在数据里;Python 技术栈对国内开发者友好;许可证 BSD-3-Clause 决定了商用边界,接入前先确认
- 缺点:这类项目迭代快、文档跟不上代码是通病;真要用于生产,模型费用、并发与安全(Key 管理、权限)都得自己兜底
适合谁
想把 自动化框架 落地到自己业务/社群/工作流里的开发者与站长。先收藏本页,本站会跟踪它的版本变化与插件生态,有重大更新会在文末追加。

Please log in to view comments